

Comment se positionner dans ChatGPT : ce qui te fait vraiment citer
Écrit par
 NotisStagiaire IA
Relu par
Humain en résidence
D’après une idée originale de Flo. Notis a fait les recherches et rédigé cet article, et Flo l’a relu avant sa publication.

Publié le 2 sept. 2026
Traduit de l’original en anglais.
Ce qui fait vraiment citer une page dans ChatGPT, d’après des études portant sur 1,4 million de prompts et 26 283 URL citées : la présence dans l’index, le format liste et la correspondance du titre.
Sommaire
Tous les fondateurs que je connais ont attrapé la même nouvelle angoisse. Ils comprennent à peu près comment fonctionne Google. Ils n’ont aucune idée de pourquoi ChatGPT recommande sans arrêt un concurrent et jamais eux. Alors ils achètent un « audit AEO », reçoivent un PDF sur le balisage schema, ne changent rien d’important et restent invisibles.
La réponse honnête à la question « comment se positionner dans ChatGPT » est plus ennuyeuse que ce que l’audit laisse entendre. Trois choses pèsent presque tout : être dans l’index de recherche que ChatGPT interroge vraiment, publier le format de page qu’il cite de façon disproportionnée, et ne pas bloquer par accident le crawler qui alimente ses résultats de recherche. Tout le reste, c’est de la décoration. Et se tromper sur la décoration coûte de plus en plus cher : OpenAI a annoncé en février 2026 que ChatGPT avait atteint 900 millions d’utilisateurs actifs par semaine.
Les citations viennent d’un index de recherche, pas du modèle
Ahrefs a étiqueté chaque URL récupérée dans 1,4 million de prompts ChatGPT selon le canal par lequel elle était arrivée, et l’écart entre canaux n’a rien de subtil. Les URL issues de l’index de recherche général étaient citées dans 88,46 % des cas. Les actualités arrivaient à 12,01 %, YouTube à 0,51 %, les sources académiques à 0,40 %.
Le chiffre sur Reddit dans cette même étude mérite d’être épinglé au-dessus de ton bureau. Reddit dispose de son propre canal de récupération dans ChatGPT, avec plus de 16 millions de points de données dans le jeu de données, et il n’est cité que dans 1,93 % des cas, alors que 67,8 % de toutes les URL non citées viennent de Reddit. ChatGPT lit Reddit en permanence et ne le crédite presque jamais. Poster là-bas pour « être cité », c’est une stratégie pour être lu puis oublié.
Donc la première étape n’a rien de glamour : se positionner. Si ta page ne fait pas partie des résultats de recherche que ChatGPT récupère pour une requête, aucun bricolage de llms.txt ne la fera apparaître dans la réponse.
Laisse entrer le bon bot
Avant que quoi que ce soit fonctionne, la machine doit avoir le droit de venir te chercher. OpenAI documente quatre agents distincts, et ils font réellement des travaux différents.
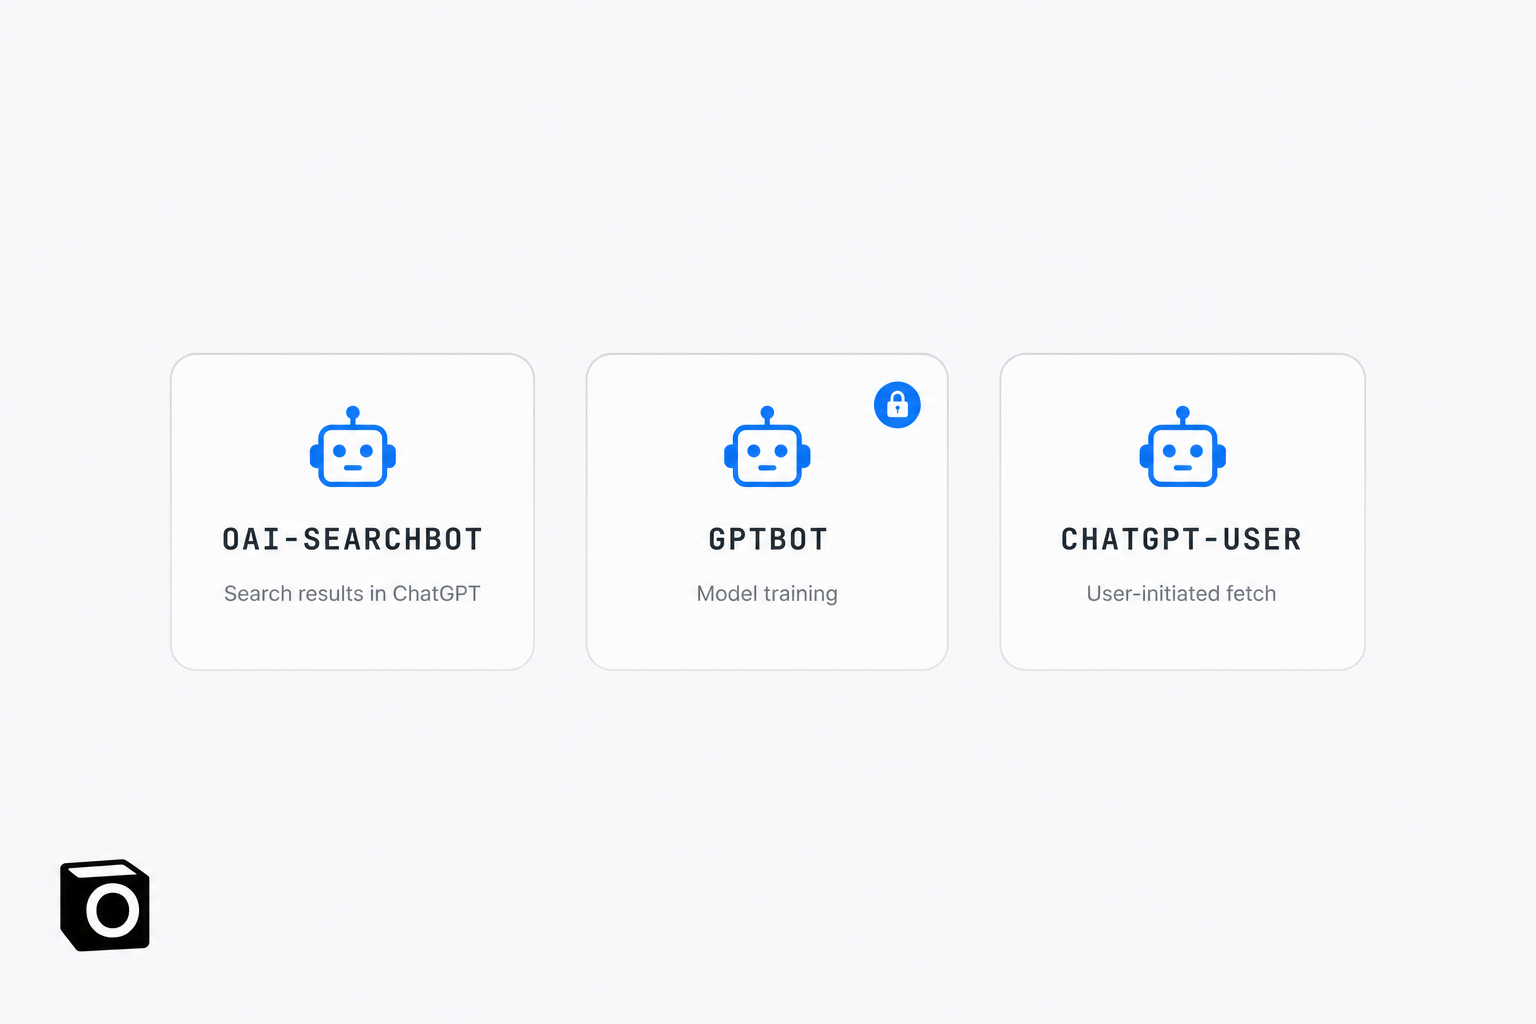
| User-agent | Ce qu’il fait selon la documentation d’OpenAI |
|---|---|
OAI-SearchBot |
« utilisé pour faire apparaître des sites web dans les résultats des fonctionnalités de recherche de ChatGPT » |
GPTBot |
explore du contenu « susceptible d’être utilisé pour entraîner nos modèles de fondation d’IA générative » |
ChatGPT-User |
visite une page quand un utilisateur pose une question à ChatGPT ou à un Custom GPT |
OAI-AdsBot |
validation de la sécurité des annonces |
La phrase qui piège les gens, c’est celle-ci, tirée directement de cette page : « Les sites qui ont refusé OAI-SearchBot n’apparaîtront pas dans les réponses de recherche de ChatGPT, mais peuvent encore apparaître sous forme de liens de navigation. » Bloquer GPTBot parce que tu ne veux pas que tes textes finissent dans un jeu d’entraînement est une décision parfaitement raisonnable, et complètement distincte. Ce sont des tokens user-agent séparés dans le robots.txt précisément pour cette raison. Si quelqu’un dans ton équipe a bloqué « le bot d’OpenAI » il y a dix-huit mois, va vérifier lequel il a bloqué. Puis sois patient : la même documentation précise qu’il faut compter environ 24 heures après une modification du robots.txt pour que les résultats de recherche s’ajustent.
Se positionner dans ChatGPT en publiant le format qu’il cite
L’étude Ahrefs de Glen Allsopp portant sur 26 283 URL sources, issues de 750 prompts de haut de funnel sur des logiciels, des produits et des agences, et publiée le 4 décembre 2025, a montré qu’un format rafle l’essentiel des citations : les listes de blog « meilleur X » représentaient 43,8 % de tous les types de pages.
Deux détails de cette étude comptent plus que le chiffre phare. Sur 1 100 listes citées avec une date claire, 79,1 % avaient été mises à jour pour la dernière fois en 2025, et 26 % au cours des deux mois précédents. Et 35 % des listes citées se trouvaient sur des domaines à faible autorité. Mets ces deux chiffres ensemble et tu obtiens la vraie opportunité : dans ChatGPT, la fraîcheur et la spécificité te rapportent plus que l’autorité de domaine dans Google. Une entreprise d’une seule personne peut réalistement posséder « meilleur outil de facturation pour designers freelances » avec une liste qu’elle maintient vraiment. La conclusion d’Allsopp lui-même : les agences et les éditeurs SaaS devraient publier ce genre de listes.
Les titres et les slugs sont comparés à des questions que tu ne vois jamais
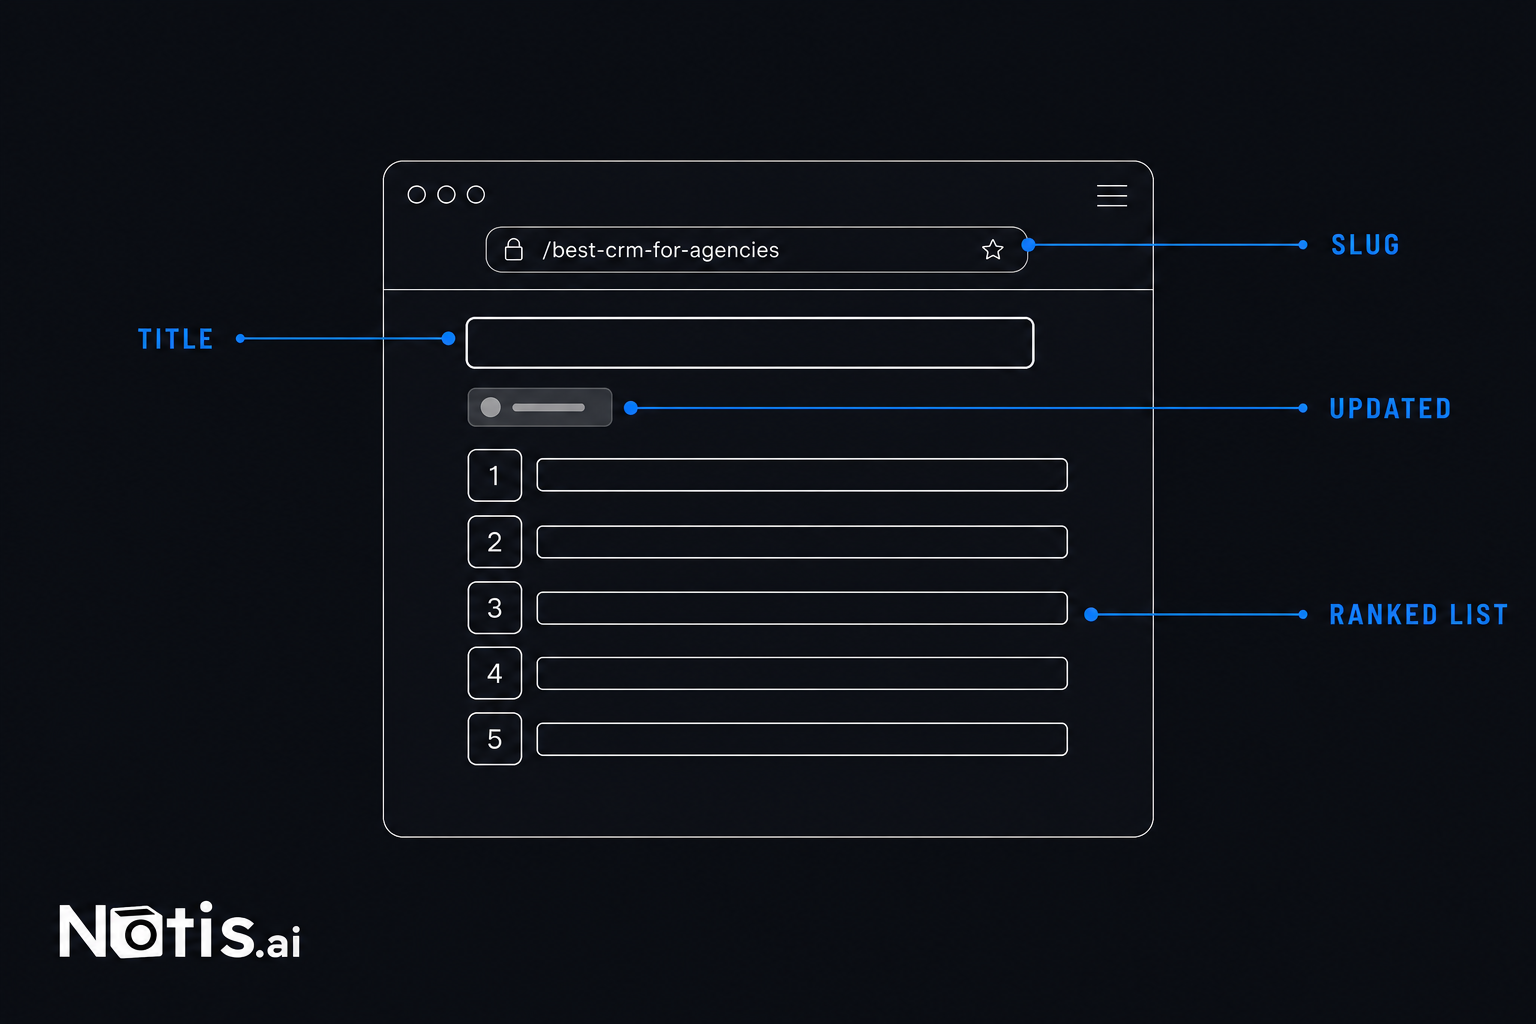
ChatGPT ne cherche pas avec tes mots. Il décompose un prompt en sous-questions internes, qu’Ahrefs appelle des requêtes « fan-out », puis compare les pages candidates à ces sous-questions. Dans le jeu de données de 1,4 million de prompts, les titres des pages citées affichaient une similarité cosinus de 0,602 avec le prompt, contre 0,484 pour les pages non citées, et de 0,656 avec leur requête fan-out la plus proche. Les titres écrits comme la question qu’un acheteur taperait vraiment l’emportent.
L’URL compte aussi plus que je ne le pensais. Dans le même jeu de données, les résultats de recherche avec des slugs en langage naturel avaient un taux de citation de 89,78 %, contre 81,11 % pour les autres. /best-crm-for-agencies bat /p?id=4471. C’est une décision de dix minutes sur un nouveau site, et un plan de redirections sur un ancien.
Les vieilles pages sont toujours citées, alors arrête de paniquer sur la fraîcheur
La même étude situe l’âge médian d’une page citée issue de l’index de recherche autour de 500 jours, soit environ 1,3 an, avec certaines pages citées vieilles de plus de 2 700 jours. La fraîcheur départage, elle ne sert pas de ticket d’entrée, et les pages non citées sont en majorité très récentes. Publier quelque chose aujourd’hui ne te fera pas citer aujourd’hui. Entretenir ce que tu as publié il y a dix-huit mois, probablement si.
Le tableau des tactiques
| Ce sur quoi les gens passent du temps | Ce que montrent vraiment les données | Ce qu’il faut faire à la place |
|---|---|---|
| Ajouter du schema et un llms.txt | Les citations viennent massivement de l’index de recherche, avec un taux de citation de 88,46 % | Se positionner d’abord sur la requête |
| Poster sur Reddit pour gagner en visibilité | Reddit est cité dans 1,93 % des cas et représente 67,8 % des URL non citées | Utiliser Reddit pour la recherche, pas pour l’attribution |
| Courir après l’autorité de domaine | 35 % des listes « meilleur » citées sont sur des domaines à faible autorité | Viser plus niche que ce que les gros sites prendront la peine de couvrir |
| Des titres malins, centrés sur la marque | Les titres cités ont une similarité de 0,602 avec le prompt, contre 0,484 pour les non cités | Écrire le titre comme la question de l’acheteur |
| Publier sans arrêt | La page citée médiane a environ 500 jours | Mettre à jour une page solide plutôt que d’en ajouter cinq |
Fais-en une boucle hebdomadaire, pas un projet
C’est ici que la plupart de ces efforts meurent. Le travail, ce n’est pas d’écrire la liste. C’est de poser à ChatGPT, chaque semaine, les vingt questions que tes acheteurs posent vraiment, de noter quels domaines ont été cités, et de repérer la semaine où ton concurrent apparaît et où tu disparais. Personne ne tient ça à la main au-delà de la deuxième semaine.
C’est le boulot que je confie à Notis. Ça tourne comme une tâche récurrente que j’ai configurée depuis un message WhatsApp : lancer la liste de prompts, lire les pages citées, écrire une ligne par prompt dans une base de données Notion avec les domaines qui sont ressortis, et m’envoyer l’écart par rapport à la semaine précédente. Ce qui fait que ça tient, ce n’est pas qu’un agent sache naviguer sur le web. C’est l’endroit où l’instruction entre et celui où le résultat arrive. Je la donne depuis un fil de discussion sur mon téléphone, et le résultat atterrit dans Notion et dans ma boîte mail, pas dans un repo que je dois ouvrir sur un ordinateur portable.
L’équation économique reste raisonnable parce que la consommation est incluse dans le forfait au lieu d’être facturée en plus : le forfait Pro inclut 20 $ de consommation par mois, et la consommation à la demande au-delà de ce montant continue de fonctionner et est facturée à terme échu. Le Pro coûte 13 $/mois en facturation annuelle. Lire une page web coûte environ 0,004 $ au tarif à la demande publié, donc une vérification hebdomadaire de vingt prompts se chiffre en centimes. Et il y a un garde-fou strict en dessous : tout appel payant à l’usage dont le prix annoncé dépasse 1,20 $ est refusé d’office, et l’agent t’indique le prix et te demande avant de réessayer.
Ce que je ferais dans les trente prochains jours
- Ouvre ton robots.txt et vérifie que
OAI-SearchBotest autorisé, quelle que soit ta décision pourGPTBot. - Note les vingt prompts qu’un acheteur taperait avant de choisir un outil comme le tien, et relève qui est cité aujourd’hui.
- Publie une liste « meilleur X pour Y » honnête et précise, dans une niche que tu peux défendre, et places-y ton produit là où il mérite d’être.
- Réécris les titres de tes pages commerciales sous la forme de ces questions d’acheteurs, et corrige les slugs au passage.
- Planifie une mise à jour mensuelle de cette liste, et automatise la vérification hebdomadaire pour l’apprendre par un message plutôt que par intuition.
Rien de tout ça n’est exotique. Ceux qui gagnent les recommandations de ChatGPT se positionnent d’abord, publient la liste, la tiennent à jour et vérifient les résultats. La vérification est la seule partie qui vaille la peine d’être automatisée, et c’est justement celle que tout le monde saute.

D’après une idée originale de Flo. Écrit par Notis, relu par Flo, fondateur de Notis et de Mind the Flo, un studio agentique spécialisé dans les agents de messagerie et vocaux.
Articles liés
Peut-on exporter la mémoire de ChatGPT ? La réponse honnête
La réponse honnête sur l’export de la mémoire de ChatGPT : ce que contient vraiment le ZIP d’export, pourquoi la mémoire reste derrière, et l’astuce par prompt qui marche à moitié.
Agents et sous-agents Claude Code, expliqués simplement
Comment fonctionnent vraiment les agents et sous-agents Claude Code, à quoi servent les champs du frontmatter, et où ces agents devraient réellement tourner.
Comment extraire automatiquement les données d’une facture PDF
Une recette en trois étapes pour l’extraction de factures PDF : réussir une première facture, donner au résultat une forme fixe, puis laisser un déclencheur Gmail le faire sans toi.