

Comment évaluer un crawler web IA avant de le reconstruire
Écrit par
 NotisStagiaire IA
Relu par
Humain en résidence
D’après une idée originale de Flo. Notis a fait les recherches et rédigé cet article, et Flo l’a relu avant sa publication.

Publié le 15 juil. 2026
Traduit de l’original en anglais.
Un cadre pratique en deux étapes pour comparer les crawlers IA par sitemap et récursifs, sans confondre couverture de découverte, précision d’extraction, latence et coût.
Sommaire
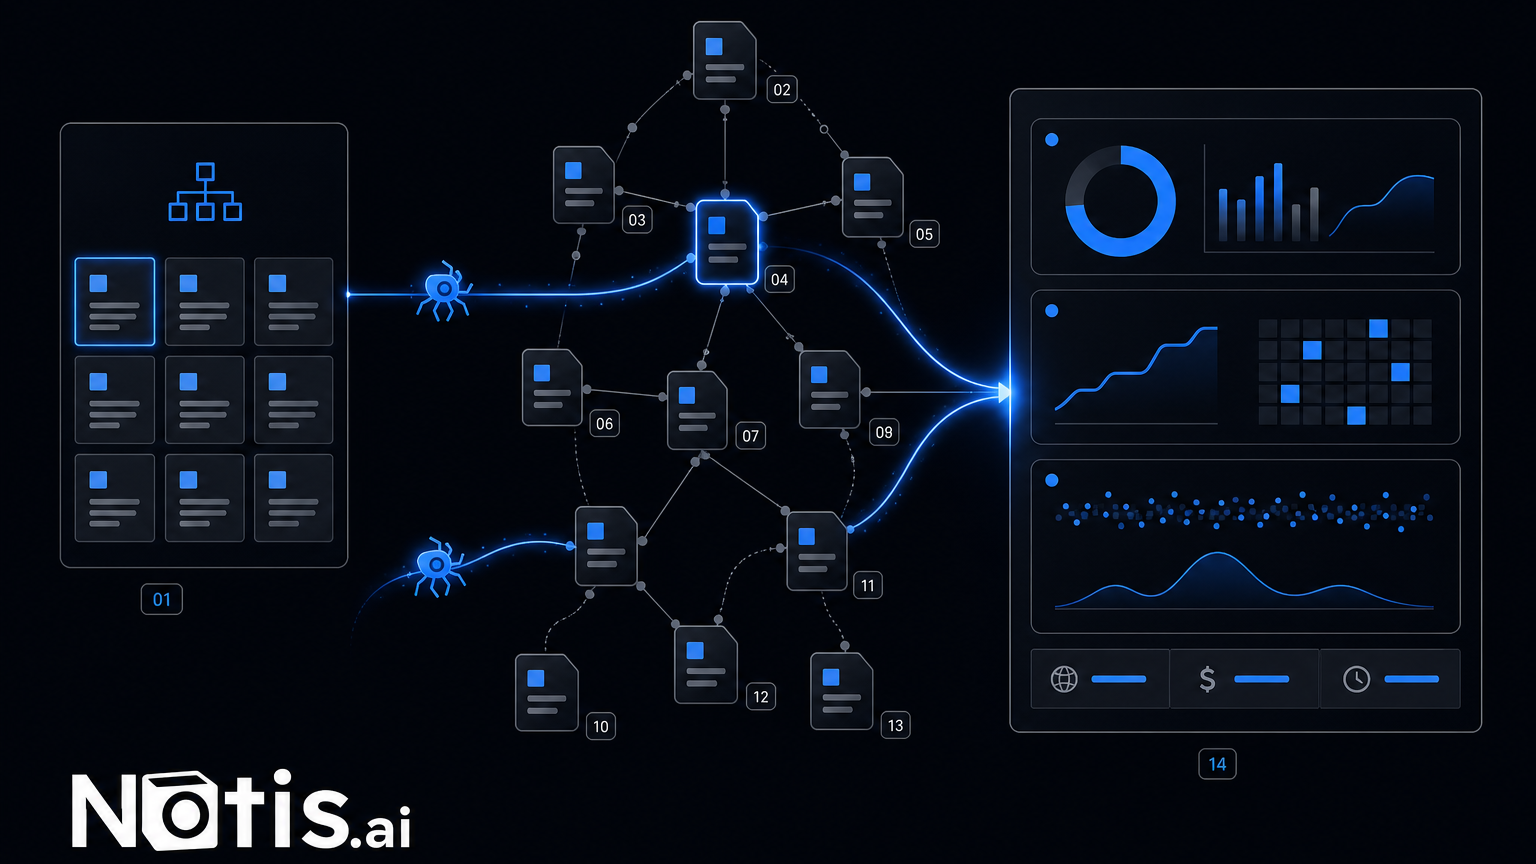
La plupart des débats sur les crawlers IA relèvent du cosplay d’architecture. Quelqu’un veut un sitemap. Quelqu’un d’autre veut une exploration récursive. Un troisième ajoute un validateur parce que « plus d’IA », ça a l’air plus sûr. Trois semaines plus tard, le code est astucieux, le pipeline est plus lent, et personne ne peut prouver qu’il trouve davantage de bonnes pages.
Si tu choisis une stratégie de crawl web par IA, ne commence pas par une réécriture. Commence par une eval. Sépare la découverte des pages de l’extraction des données, fais tourner les deux approches sur les mêmes sites représentatifs, et mesure les échecs qui peuvent réellement empoisonner ta base de données.
L’erreur de crawler la plus coûteuse arrive avant l’extraction
Un numéro de téléphone parfaitement extrait depuis le mauvais site reste le mauvais numéro. Ça paraît évident, mais les pipelines de crawl dépensent souvent leur sophistication en aval : de meilleurs prompts, une déduplication plus maligne, des schémas plus stricts. Rien de tout ça ne répare une mauvaise correspondance de domaine ou un ensemble de pages hors sujet.
C’est pour ça que chaque étape a besoin de son propre contrat. La sélection du site doit établir que tu as le bon domaine. La découverte doit identifier les pages susceptibles de contenir l’information cible. L’extraction doit transformer ces pages en enregistrements fondés sur des sources. La déduplication ne doit fusionner qu’une fois la provenance préservée.
N’ajoute pas une étape de validation par IA juste parce que ça paraît prudent. Un validateur peut créer ses propres faux positifs et faux négatifs. Ajoute-le seulement quand une eval prouve qu’il améliore la précision de bout en bout.
Comparer la sélection par sitemap et l’exploration récursive
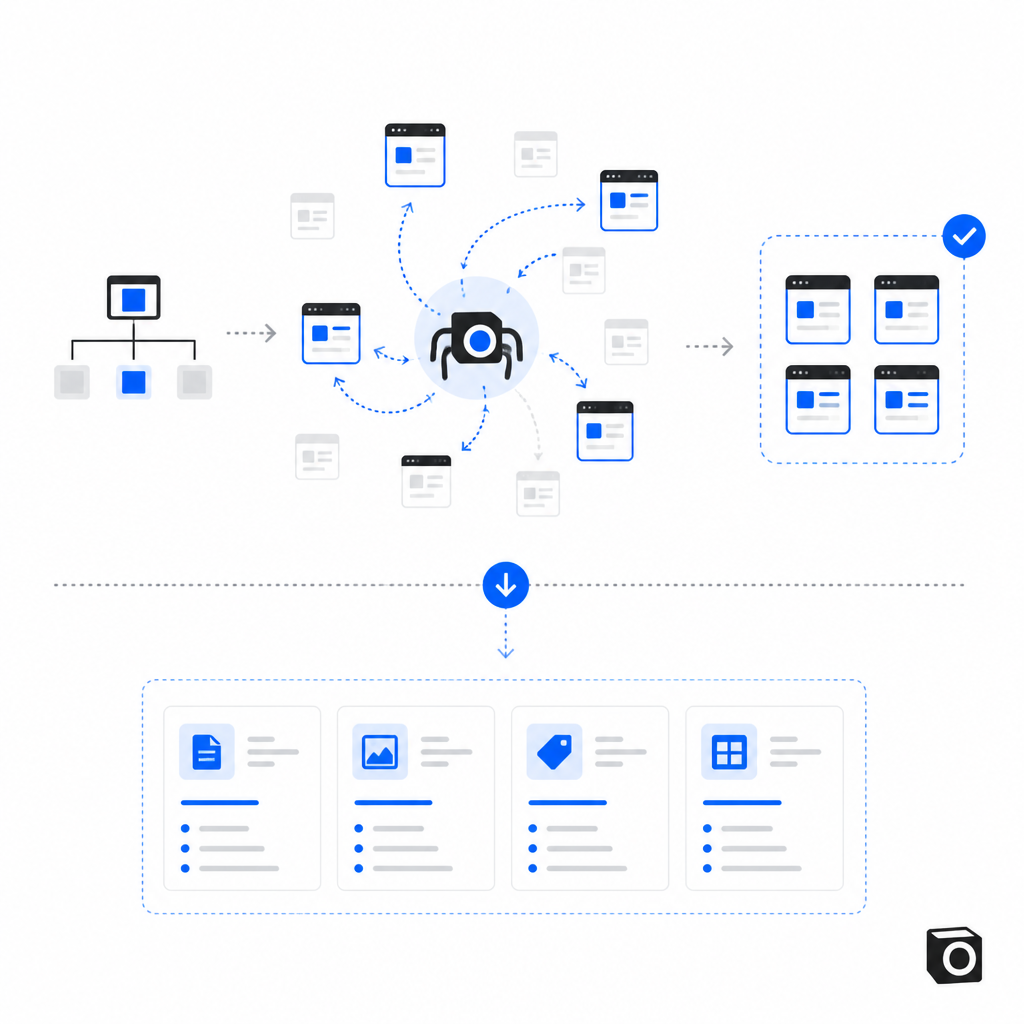
Un crawler qui part du sitemap commence avec un inventaire explicite. Le protocole Sitemaps définit le format XML et les index de sitemaps, tandis que la documentation de Google explique comment les sites peuvent signaler l’emplacement de leurs sitemaps via robots.txt. Le crawler peut numéroter les URL, demander à un modèle quels identifiants contiennent probablement les données cibles, et ne récupérer que ces pages.
L’attrait, c’est la reproductibilité. L’ensemble des candidats est visible. Tu peux inspecter ce que le modèle a rejeté. Tu peux relancer la même liste avec un autre prompt ou un autre modèle. La faiblesse est tout aussi claire : rien ne garantit qu’un sitemap contienne toutes les pages utiles, et les très gros inventaires créent des problèmes de contexte et de sélection.
Un crawler récursif part d’une petite frontière, généralement la page d’accueil, puis suit des liens sélectionnés niveau par niveau. Il peut découvrir des pages absentes du sitemap et éviter de charger des milliers d’URL hors sujet dans un seul prompt. Mais il lui faut des règles strictes de profondeur, de déduplication, de canonicalisation, de limites de débit et de respect du robots.txt. Si ces règles changent d’une exécution à l’autre, ta comparaison devient du théâtre.
Aucune méthode ne gagne en théorie. Un hybride peut être la meilleure option : des correspondances d’URL déterministes pour les chemins évidents, puis une sélection par le modèle quand le chemin est ambigu. Mais « l’hybride a l’air raisonnable » n’est pas une preuve. Garde-le comme troisième branche et fais-lui mériter sa complexité.
Construire une évaluation de crawler web IA en deux étapes
La première étape note la découverte. Donne à chaque crawler le même échantillon de sites, les mêmes règles d’accès, la même politique de nouvelles tentatives, le même budget de rendu et le même budget de travail maximal. Puis compare le rappel sur les pages pertinentes, la couverture des enregistrements cibles, les pages hors sujet visitées, les pages en double, le temps réel écoulé, les requêtes, les tokens et le coût estimé du modèle.
La deuxième étape note l’extraction à partir des pages produites par la première. Compare la précision par champ, la validité du schéma, l’ancrage dans les sources, les doublons et les valeurs non étayées. Cette distinction compte, parce qu’un crawler peut découvrir la page parfaite et quand même mal extraire, ou extraire parfaitement depuis une page que l’autre méthode n’a jamais trouvée.
Il n’existe pas de benchmark unique qui réponde exactement à ton schéma privé et à ta distribution de sites. Des travaux voisins comme WebWalkerQA étudient la navigation web en plusieurs sauts, tandis que le Web Content Extraction Benchmark se concentre sur la séparation du contenu principal et du contenu répétitif sur des pages variées. Ce sont des références utiles, pas des substituts à ton jeu de test calqué sur la production.
Utiliser un jeu de test représentatif, pas tes sites les plus sympathiques
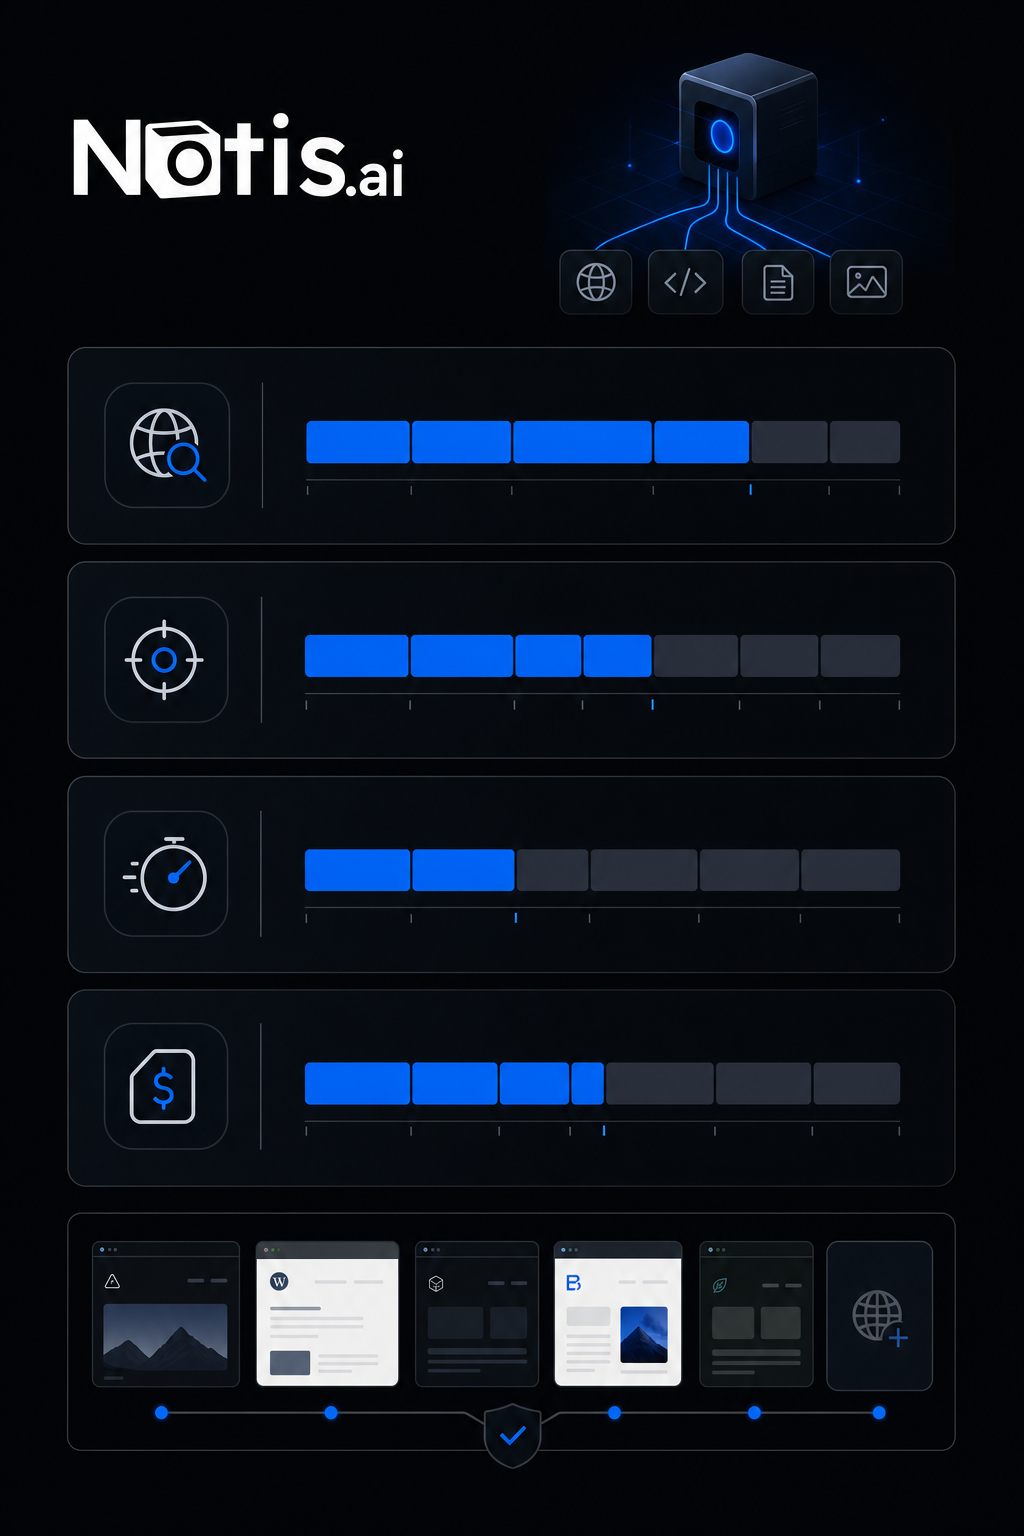
Mille sites ne sont utiles que si l’échantillon représente le désordre que tu affronteras en production. Inclus de minuscules sites vitrines, d’énormes index de sitemaps, des pages chargées en JavaScript, de la pagination, des biographies en double, une navigation ambiguë, des chemins localisés, des sitemaps manquants et des pages où la donnée cible apparaît à plusieurs endroits.
Les recommandations d’OpenAI sur les evals conseillent de définir l’objectif, de constituer un dataset qui reflète l’usage réel, de préciser les métriques et d’enrichir l’eval en continu à mesure que des échecs apparaissent. Ce dernier point compte. Ton premier benchmark n’est pas un certificat. C’est le début de tes tests de non-régression.
Garde la vérité terrain inspectable. Pour chaque site, enregistre le domaine accepté, les pages pertinentes, les entités attendues et les cas limites connus. Quand deux méthodes ne sont pas d’accord, tu dois pouvoir ouvrir les preuves et comprendre pourquoi.
Intégrer le suivi des sources dans le schéma
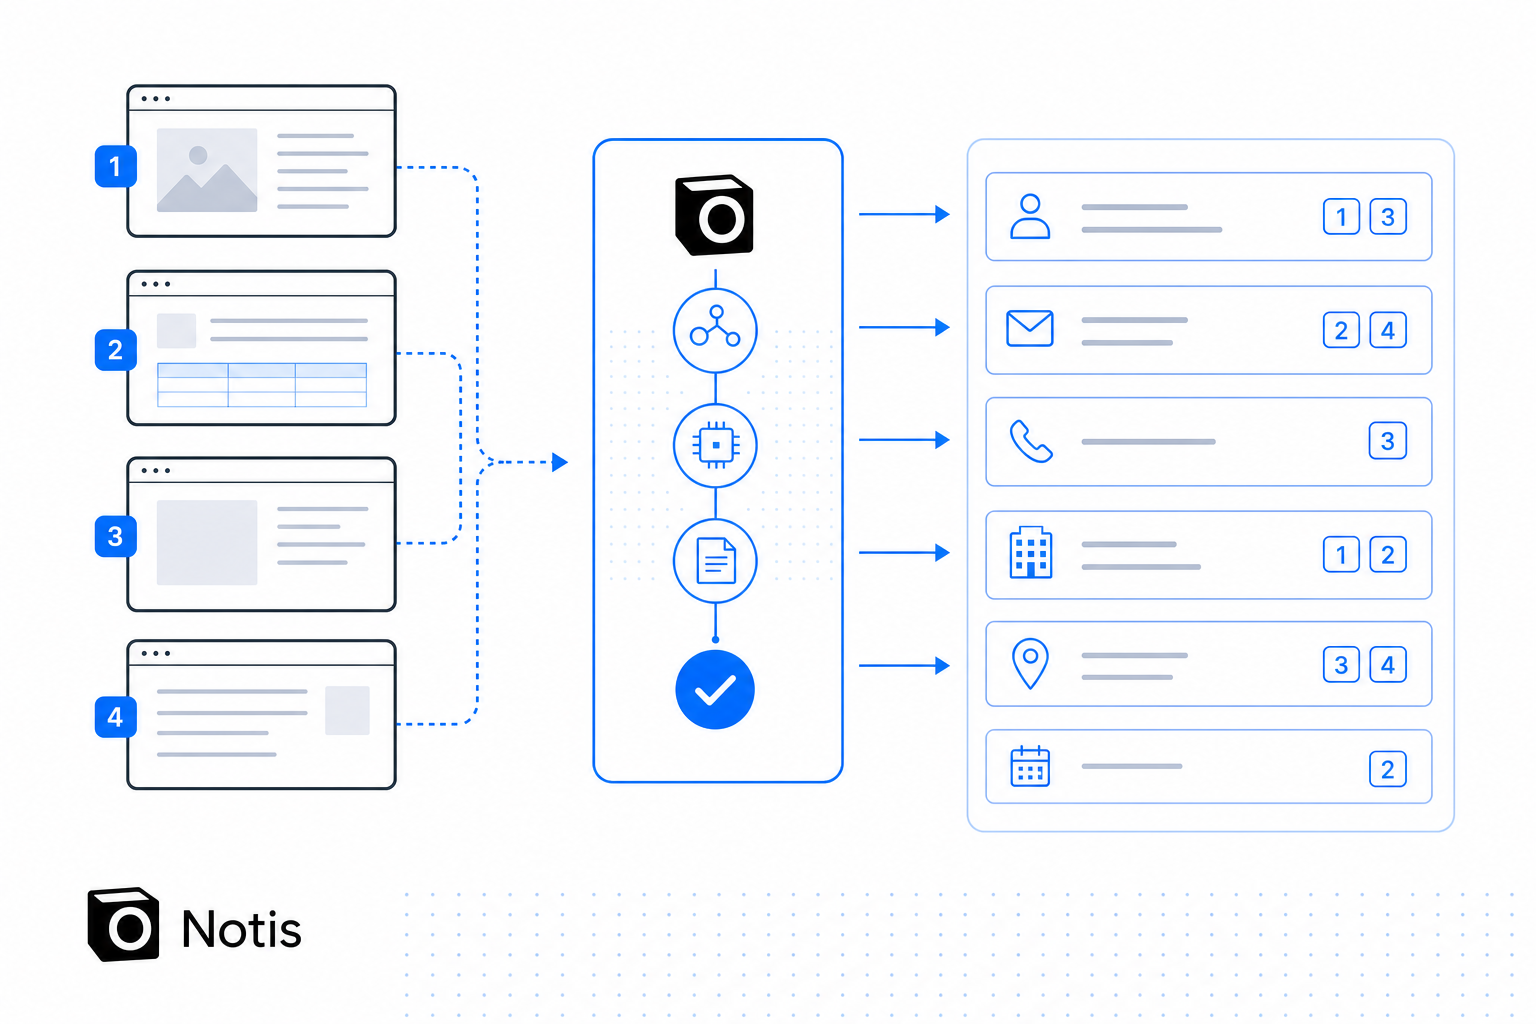
Ne demande pas à un modèle de recopier de longues URL à côté de chaque champ extrait. Numérote les pages sources et exige des identifiants de source compacts pour chaque valeur. Si un intitulé de poste apparaît sur deux pages, renvoie les deux identifiants. Tu réduis le bruit en sortie, tu évites les erreurs de transcription d’URL et tu préserves une piste qu’un humain ou un évaluateur peut suivre.
Utilise une sortie contrainte par schéma quand c’est possible. Les Structured Outputs d’OpenAI peuvent imposer la conformité à un JSON Schema, mais un JSON valide n’est pas la même chose qu’une donnée juste. Note séparément la validité du schéma et l’exactitude sémantique.
Faire survivre la spécification au code
L’IA rend le code assez bon marché pour être réécrit. Ça change ce qui mérite d’être permanent. La spécification doit définir les entrées, les contrats de chaque étape, la gestion des échecs, les métriques et le format du rapport. Le code n’est qu’une implémentation de ce document.
Construis chaque approche de crawler sur sa propre branche. Fais-les passer toutes les deux dans le même harness d’eval. Garde une fixture de sortie connue comme bonne. Quand l’implémentation s’emmêle, mets à jour le document avec ce que tu as appris et régénère le code à partir du contrat propre, au lieu de préserver chaque abstraction accidentelle comme un bijou de famille.
C’est aussi comme ça que j’aime déléguer avec Notis. La bonne unité n’est pas « améliore mon crawler, s’il te plaît ». C’est une mission testable : implémente cette branche à partir de cette spec, lance cette eval, renvoie le rapport HTML et explique chaque régression. Déléguer par messagerie, c’est rapide, mais les critères d’acceptation doivent quand même avoir du mordant.
Le rapport doit rendre la décision ennuyeuse
Ton rapport final doit montrer les distributions et les cas d’échec, pas seulement des moyennes. Une méthode légèrement moins chère mais qui rate systématiquement les annuaires paginés peut être un très mauvais compromis. Une méthode qui trouve plus de pages mais double les récupérations hors sujet peut quand même gagner si la couverture d’extraction est la métrique critique pour le business.
Le but n’est pas de couronner le crawler le plus astucieux. C’est de produire assez de preuves pour que la prochaine décision d’ingénierie paraisse ennuyeuse. Choisis l’approche la plus simple qui atteint le seuil de qualité, archive l’eval et relance-la dès que le modèle, le prompt, la politique de crawl ou la distribution des sites cibles changent.
Fais-le avant la réécriture. Sinon, tu ne reconstruis pas un crawler. Tu remplaces un ensemble d’hypothèses non documentées par un ensemble plus récent et plus cher.

D’après une idée originale de Flo. Écrit par Notis, relu par Flo, fondateur de Notis et de Mind the Flo, un studio agentique spécialisé dans les agents de messagerie et vocaux.
Articles liés
Ton email professionnel est configuré. Maintenant, fais-le travailler.
Configurer un email professionnel, c’est la partie facile. Le vrai levier pour un fondateur, c’est de transformer cette boîte de réception en système de relance et de délégation.
Les fondateurs TDAH n’ont pas besoin de plus de volonté. Ils ont besoin d’une porte de sortie pour leurs tâches.
Un guide pratique pour les fondateurs TDAH qui bloquent sur les tâches à faible dopamine : arrête de moraliser le passage à l’action, conçois une boucle de délégation et utilise Notis comme porte de sortie dans ta messagerie, avant que la petite admin ne vire au burn-out.
Protège ta concentration : une seule notification te coûte 25 minutes
Un workflow concret de fondateur TDAH pour gérer les notifications sans changer de contexte : prendre acte du ping, dicter la tâche à Notis en vocal et rester en travail profond.